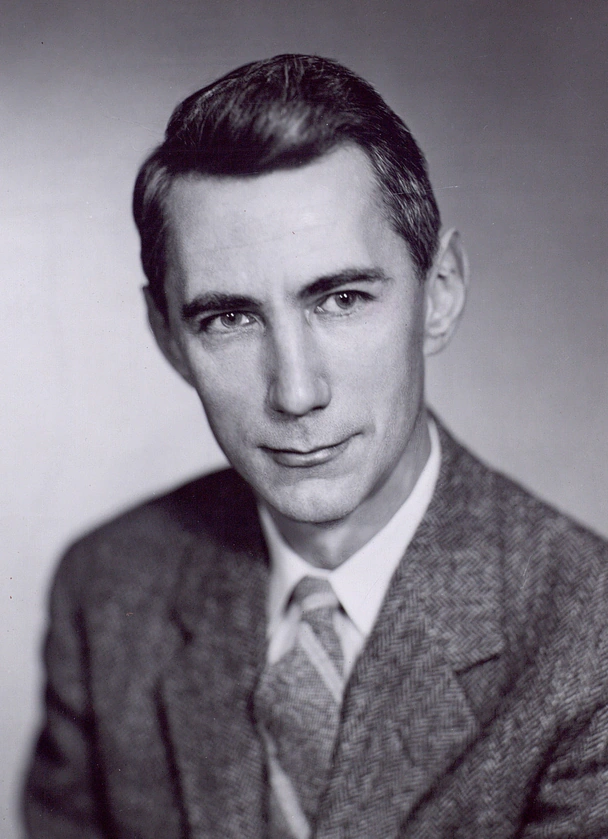
Claude Shannon · 1916–2001

香农

他让「信息」成了可以称量的东西,还证明了噪声限制的是速度、不是可靠性

H=ipilog2piH = -\sum_i p_i \log_2 p_i
信息熵 · 一条消息里究竟有多少比特

克劳德·香农生于密歇根州的佩托斯基,在附近的盖洛德长大。父亲经商、做过遗嘱检验法官,母亲是中学校长。他少年时拿农场围栏的带刺铁丝当电报线,接到一英里外朋友家;后来他喜欢提爱迪生是自己很远的一位本家——两人都是同一位十七世纪移民的后代。1932 年入密歇根大学,1936 年同时拿下电机工程与数学两个学位,接着到麻省理工给万尼瓦尔·布什的微分分析机当助手。那是一台机械式模拟计算机,控制它的是一百来只继电器接成的一团线路。他在密歇根的一门哲学课上学过布尔代数,此刻认出那团线路就是布尔的式子:串联是与,并联是或,化简电路就是化简式子。这就是 1937 年那篇硕士论文——那件展品陈列在布尔的厅里,因为它是布尔等了七十三年的那件事。1940 年他以一篇《理论遗传学的一种代数》拿到博士学位,那个题目他此后再没碰过。

1941 年他进贝尔实验室,战时做高射炮火控与密码系统的数学验证。1943 年头三个月图灵在贝尔实验室,两人常在午茶时碰面,谈的是机器能不能思考——各自的密码工作则从不互相提起。1945 年 9 月 1 日他交出机密报告《密码学的数学理论》,四年后解密发表;他后来说,密码那一套和通信那一套「靠得太近,分不开」。1948 年七月与十月,《贝尔系统技术杂志》分两期登出《通信的数学理论》,前后七十九页,一门学科几乎是从空地上立起来的。论文开篇先划界:通信的语义方面与工程问题无关——要先把「意思」请出去,「信息」才称得出重量。比特这个词也是在这篇里第一次印出来的,他在脚注里注明是图基建议的。1956 年他写《赶潮流》,劝同行别把信息论吹过头。同年回麻省理工,1958 年起任教到 1978 年。他造过会走迷宫的电子老鼠忒修斯、会下残局的机器、会自己把自己关掉的「终极机器」,在贝尔实验室的走廊上骑独轮车玩杂耍,还写过一篇正经论文讨论杂耍的定理。1993 年后他患上阿尔茨海默症,2001 年 2 月 24 日卒于马萨诸塞州梅德福,没能看见互联网把他那套定理用成什么样子。

香农肖像
佚名摄 · 瑞典国家科技博物馆藏(Tekniska museet 43069)· Wikimedia Commons,CC BY 2.0

生平

  1. 1916
    生于密歇根佩托斯基

    在盖洛德长大。少年时拿农场围栏的带刺铁丝当电报线,接到一英里外朋友家。

  2. 1936
    密歇根大学双学位

    电机工程与数学。随后到麻省理工,给布什的微分分析机当助手。

  3. 1937
    硕士论文:开关网络就是布尔代数

    串联是与,并联是或。这件展品在布尔的厅里——它是布尔等了七十三年的那件事。

  4. 1940
    博士论文《理论遗传学的一种代数》

    那个题目他此后再没碰过。同年到普林斯顿高等研究院做一年研究员。

  5. 1941
    进贝尔实验室

    战时做高射炮火控与密码系统的数学验证。

  6. 1943
    与图灵的几顿午茶

    图灵在贝尔实验室的三个月里,两人谈机器能不能思考;各自的密码工作从不互相提起。

  7. 1945
    机密报告《密码学的数学理论》

    1949 年解密发表。他说密码那一套和通信那一套靠得太近,分不开。

  8. 1948
    《通信的数学理论》

    七月与十月分两期,七十九页。熵、信源编码定理、有噪信道编码定理——一门学科从空地上立起来。

  9. 1949
    采样定理与完善保密

    《有噪声时的通信》给出每秒 2B 个样本;《保密系统的通信理论》证明一次一密不可破。

  10. 1956
    《赶潮流》

    劝同行别把信息论吹过头。同年回麻省理工,1958 年起任教到 1978 年。

  11. 2001
    卒于马萨诸塞州梅德福

    1993 年后患阿尔茨海默症,没能看见互联网把他那套定理用成什么样子。

展品厅

绝大多数展品都可以亲手把玩——这是本馆的立馆之本;少数以叙述为主的,做成故事展签。

一条消息里有多少「意外」

他把信息量定义成意外的平均值:越是没想到的事,说出来越值钱。

H(X)=ipilog2piH(X) = -\sum_i p_i \log_2 p_i

1948 年之前,「信息」不是一个能算的量。香农的办法是先问一个更小的问题:收到一个符号,你得到了多少东西?如果那件事本来就必然发生,你什么也没得到;越是出乎意料,得到的越多。于是把一个概率为 p 的符号所带的量定成 log(1/p),再对整个信源取平均,就是熵。取 2 做底,单位叫比特——这个词也是在那篇论文里第一次印出来的,他在脚注里注明是图基建议的。这个定义不是凭空挑的:他先写下三条要求(连续、等概率时随符号数递增、分步选择时可以拆开相加),再证明满足这三条的函数只能是这一个,差一个常数倍。至于为什么叫「熵」,据香农后来对特里布斯的转述,是冯·诺依曼劝的:这个式子在统计力学里已经叫了这个名字,而且「没人真懂熵是什么,争起来你总占上风」。

收到一个符号,你到底得到了多少东西?香农的答案是:看它有多出乎意料。一件必然发生的事说出来等于没说;一件只有千分之一机会的事说出来,你得到的是 log₂1000 ≈ 10 位。把每个符号的意外量按它自己的概率加权平均,就是这个信源的熵。它有一个上限:n 个符号等概率时最大,等于 log₂n;只要概率不均匀,熵就往下掉,掉下去的那部分叫冗余。英文那一档是现算的——二十七个符号(空格加 a–z)如果等概率,每个字母值 4.7549 位;按真实频率算只有 4.0968 位,也就是说单看字母频率,英文就已经浪费掉了 13.8%。而这还只是第一层,把「前一个字母是什么」也算进去还能再掉一大截(见「英语有一半是废话」那件)。至于为什么叫「熵」:据香农后来对特里布斯的转述,是冯·诺依曼劝他用的——这个式子在统计力学里早就叫这个名字,而且「没人真懂熵是什么,争起来你总占上风」。

压缩的地板在哪里

一个信源平均每符号最少要多少位?答案正好是它的熵,一位都少不了。

H(X)Lˉ<H(X)+1H(X) \le \bar{L} < H(X) + 1

这是他的第一条编码定理,也是今天每一次压缩背后的那条线。它说的是两件事:一,平均码长不可能低于熵——低于熵的编码一定会把两条不同的消息编成同一串,解不回来;二,这个地板是够得着的,只要允许把若干个符号打成一包一起编,每符号的平均码长就能任意接近熵。单个符号编时会有零头:最优的前缀码(哈夫曼 1952 年给出的那套,比香农自己 1948 年用的办法更紧)保证平均码长落在熵与熵加一之间,那个「加一」就是零头。把两个符号当一个来编,零头摊薄成一半;三个符号,摊成三分之一。演示里那个九一开的二元源,熵是 0.4690 位,单符号编时只能是 1.0000 位,打包到六个就降到 0.4702——地板一直在那儿,只是要走近它得成包地走。而且贴近的过程并不单调:把 A 的机会拨到 80%,每包三个反而比每包四个更省,定理保证越收越紧的是上界 H + 1/k,不是每一档的实际码长。

一个九一开的二元源,每个符号最少要几位?直觉说「一位,再少就没法区分了」。香农说 0.469 位——那是这个信源的熵,也是压缩的地板。地板下不去:任何平均码长低于熵的编码,一定会把两条不同的消息编成同一串,解不回来。地板又够得着:一个符号一个符号地编确实只能是 1 位,可要是允许把若干个符号打成一包一起编,零头就被摊薄了,每符号的平均码长一路朝熵靠过去。这就是信源编码定理,今天每一次压缩——ZIP、JPEG、MP3、视频编码——都在这条线以上活动。有两处容易看错:一是这里用的最优前缀码是哈夫曼 1952 年的办法,比香农自己 1948 年用的那套更紧,香农定的是地板在哪儿,哈夫曼解决的是怎么每次都编到最优;二是实线并不单调——把 A 的机会拨到 80%,k=3 反而比 k=4 更省。定理保证越收越紧的是那条虚线上界 H + 1/k,不是每一档的实际码长。

镇馆之宝 · 亲手玩

噪声限制的是速度,不是可靠性

在一条会出错的线上,仍然可以把出错概率压到任意小——只要你别传得太快。

CBSC=1H(p),H(p)=plog2p(1p)log2(1p)C_{\text{BSC}} = 1 - H(p), \quad H(p) = -p\log_2 p - (1-p)\log_2(1-p)

这是那篇论文里最反直觉的一条,当年几乎所有工程师都以为它是错的。此前大家相信:线路有噪声,就只能靠重复来压低错误率——说三遍取多数,说五遍取多数,错误确实越来越小,可传输速率也跟着掉向零。香农证明的是另一回事。每条信道有一个数 C,叫容量;只要你的传输速率低于 C,就存在一种编码,能把错误概率压到任意接近零,而速率不必再降。高于 C,则怎么编都不行。一条每位有 10% 概率翻转的线,容量是 0.531 位每次使用——也就是说你本来可以在这条烂线上稳稳地跑到半个比特每次,而重复码跑到 0.2 时错误率还有 0.86%。证明本身是存在性的:他不给出那个好码,而是证明随机挑一个码平均就够好,于是至少存在一个。此后半个世纪的编码理论,做的都是同一件事——把那个存在的东西真正造出来。

调噪声大小,看容量那道墙;再看重复码怎样一路降速也追不上它

一条每位有 10% 概率翻转的线。想传得准一点,老办法是重复:说三遍取多数,错误率从 10% 降到 2.8%;说三十一遍,降到十亿分之七。代价是速率一路掉向零——说三十一遍时,每次使用只换来 0.032 位真消息。1948 年之前,所有人都以为这就是噪声的本性:要可靠就得慢,越可靠越慢。香农证明的是完全另一回事。每条信道有一个数 C 叫容量,这条线的 C 是 0.531 位每次使用;只要速率低于 C,就存在一种编码,能把错误概率压到任意接近零,而速率不必再降。高于 C,怎么编都不行。画面上那道墙左边的一整条带子,都是可以既快又准的地方——重复码只走了贴着地面的那一条路。证明本身不给出那个好码:他证的是随机挑一个码平均就够好,所以至少存在一个。此后半个世纪的编码理论——汉明码、里德–所罗门码、Turbo 码、LDPC——做的都是同一件事:把那个「存在」真正造出来。今天的 5G 与硬盘,就贴着这道墙在跑。

每秒两个样本就够了

一段带宽有限的波形,只要采得够密,中间那些没采到的点一个也没丢。

x(t)=nx(n/fs)sinc(fstn),fs>2Bx(t) = \sum_n x(n/f_s)\,\mathrm{sinc}(f_s t - n), \quad f_s > 2B

一段连续的波形有无穷多个点,而数字系统只能存下有限个数。凭什么可以只留下一串样本?答案是:如果这段波形里不含高于 B 的频率,那么每秒采 2B 个样本,原波形就被完全确定了——中间的每一点都能用一串 sinc 函数精确地插回来。采不够密就会混叠:一个高频正弦被当成低频的认了,而且认得理直气壮,事后无从分辨。要留意一处常被写错的地方:门槛是「严格大于两倍最高频」。演示里那段最高含 5 赫兹分量的波形,采样率取 10 恰好等于两倍,重建最大偏差还有 0.31,两条线肉眼可见地岔开;取到 11 才落到 0.012,取 14 落到 0.0033。这条定理香农并非第一个写下,惠特克 1915 年、奈奎斯特 1928 年、科捷利尼科夫 1933 年各自触到过,他自己在 1949 年那篇里也说这在通信界已是常识,只是似乎没人明确写进文献。CD 取 44.1 千赫,正是给人耳上限 20 千赫的两倍再留一点滤波器的余地。

一段连续的波形有无穷多个点,数字系统却只存得下有限个数。凭什么可以只留下一串样本?因为如果这段波形里不含高于 B 的频率,那么每秒采两倍于 B 个点,原波形就被完全确定了——中间每一个没采到的点,都能用一串 sinc 函数精确地插回来。采不够密就会混叠:一个高频正弦被当成低频认下来,而且它穿过的样本点与真信号一模一样,事后无从分辨。有一处常被写错:门槛是「严格大于两倍」。这段信号里正好含一个 5 Hz 的分量,所以采样率取 10 Hz 恰好等于两倍时,重建最大偏差还有 0.31,两条线肉眼可见地岔开;取到 11 Hz 才落到 0.012。这条定理香农并不是第一个写下的——惠特克 1915 年、奈奎斯特 1928 年、科捷利尼科夫 1933 年各自触到过,他自己在 1949 年那篇里也说这在通信界已是常识,只是似乎没人明确写进文献;他做的是把它放进信息论的框架里讲清楚。至于 CD 为什么是 44.1 千赫:人耳上限约 20 千赫,两倍是 40 千赫,多出来的 4.1 千赫留给抗混叠滤波器做过渡。

英语有一半是废话

把英文的统计规律一层层喂给机器,它吐出来的东西就一步步像起人话来。

R=1Hlog227R = 1 - \frac{H}{\log_2 27}

如果英文的每个字母都独立等概率,二十七个符号(含空格)每个字母就值 log₂27 ≈ 4.75 位。可字母不是等概率的,也不是独立的。香农在 1948 年那篇里做了一个此后被抄过无数遍的演示:按零阶、一阶、二阶、三阶、词一级的统计依次生成文本,让人亲眼看着它从乱码变成几乎能读的句子。这不是文字游戏——每提高一阶,每字母的熵就掉一截,而掉下去的那部分正是英文的冗余。演示里这份统计取自一本公有领域的英文小说:零阶 4.7549 位,一阶 4.0968,二阶 3.3014。香农自己 1951 年算到三阶是 3.1 位,又用「让人猜下一个字母」的办法把上限压到 1 位上下。他给出的结论是:不计八个字母以外的远距离结构,普通英文的冗余大约是 50%。冗余不是缺点——正因为有它,你才读得懂缺了几个字母的句子,拼写检查才可能,填字游戏才玩得成。

1948 年那篇论文里,香农做了一个此后被抄过无数遍的演示:按零阶、一阶、二阶、三阶、词一级的统计依次生成文本,让人亲眼看着它从乱码变成几乎能读的句子。这不是文字游戏——每提高一阶,每字母的熵就掉一截,而掉下去的那部分正是英文的冗余。这里的统计取自一本公有领域的英文小说:二十七个符号等概率时每字母 4.7549 位,按字母频率算 4.0968 位,再把「前一个字母是什么」算进去只剩 3.3014 位。演示只做到二阶是有原因的:三元统计有近两万个格子,而这份语料只有六十九万字符,算出来的三阶熵会明显偏低——那是过拟合,不是英语变简单了。所以三阶与词一级直接引香农自己印出来的样例。他 1951 年用「让人猜下一个字母」的办法,把长程的上限压到 1 位上下,并给出那句常被引用的结论:不计八个字母以外的远距离结构,普通英文的冗余大约是 50%。冗余不是毛病——正因为有它,你才读得懂缺了几个字母的句子,拼写检查才可能,填字游戏才玩得成。

1943 年的几顿午茶

两个正在替各自国家保密的人坐在同一张桌边,谁也不能提自己在做什么。

1943 年一月到三月,图灵以英方代表的身份待在贝尔实验室,为跨大西洋的语音加密系统做评估。香农那时正给同一套系统做数学验证。两人几乎每天在午茶时碰面,谈的是机器能不能思考——图灵把 1936 年那篇《论可计算数》给他看,香农则谈他心里那个「怎么把信息传过噪声」的问题。唯独各自的密码工作,两人一个字也没提,也不能提。这件事后来常被讲成一场伟大的思想交汇,其实两人都说过,彼此的具体工作互不知情。真正接得上的是另一头:香农 1945 年 9 月 1 日交出的那份机密报告《密码学的数学理论》,用的正是后来那篇通信论文的整套语言——他证明了一次一密是不可破的,条件是密钥与消息一样长、只用一次;而这个「不可破」第一次有了精确的意思,即密文不含关于明文的任何信息。他后来说,密码那一套和通信那一套「靠得太近,分不开」。信息论不是从电话线里长出来的,是从密码里长出来的。

故事展签故事展签:两个人在同一张桌边,各自带着一件不能说的事。

传承

他的工作没有留在十八世纪——每条链的终点,都是你今天正在使用的东西。

熵与信源编码定理哈夫曼码、算术编码与字典类压缩ZIP、JPEG、MP3 与今天每一次视频编码
有噪信道编码定理汉明码、里德–所罗门码、Turbo 码与 LDPC深空探测、硬盘、二维码与 5G 都贴着容量在跑
采样定理模数转换与数字信号处理CD、数字音频、数字影像与一切采样系统
《保密系统的通信理论》完善保密的定义与一次一密的证明现代密码学的「可证明安全」就是从这里开始写的
熵作为不确定性的度量互信息、相对熵与最大熵原理机器学习里的交叉熵损失、决策树的信息增益

语录

通信的根本问题,在于一端要精确地或近似地重现另一端选定的一条消息。

—— 《通信的数学理论》开篇,《贝尔系统技术杂志》第 27 卷,1948

信息论这几年成了某种科学界的赶潮流……它被吹起来的重要性,已经超过了它实际的成就。

—— 《赶潮流》社论,IRE 信息论汇刊,1956 年 3 月

我设想有那么一天,我们之于机器人就像狗之于人;而我是站在机器那一边的。

—— 《Omni》杂志专访,1987 年 8 月