Richard Wesley Hamming · 1915–1998

汉明

机器夜里无人看管地算,查出一个错就把整道题扔下——他问的是:既然查得出有错,为什么不能指出错在第几位、然后改掉

2mi=0t(ni)2n2^m \sum_{i=0}^{t} \binom{n}{i} \le 2^n
把每个码字四周半径 t 的球都摆进 n 维立方体的 2ⁿ 个顶点里,球与球不许相交——能塞下多少个码字,这一行就是上界。等号成立时球把空间填得一点缝都不剩,那样的码叫完美码

理查德·卫斯理·汉明 1915 年 2 月 11 日生于芝加哥。1937 年在芝加哥大学得数学学士,1939 年内布拉斯加大学硕士,1942 年在伊利诺伊大学厄巴纳-香槟分校得数学博士,论文题为《线性微分方程边值理论中的若干问题》,导师特日青斯基——他的出身是微分方程,不是电机工程。1945 年他去了洛斯阿拉莫斯,管曼哈顿计划的计算机。这段经历他自己讲得很低:「我被叫去管那些别人已经弄起来的计算机器,好让那些科学家和物理学家回去做正事。我看出自己是个跑腿的。」——海军研究生院的纪念页称他为「曼哈顿计划计算设施的主任」,而他本人用的词是 stooge。也正是在那里,他近距离看见了费曼、费米、泰勒、奥本海默,以及他的顶头上司贝特。

1946 年他进贝尔实验室,一待三十年。刚去的时候他和香农合用过一间办公室——「同一段时间里他在做信息论,我在做编码论」。1976 年从贝尔实验室退休后,他到蒙特雷的海军研究生院教书,一直教到 1998 年 1 月 7 日去世。1968 年的图灵奖是发给他的,授奖词里排在最前面的不是纠错码而是数值方法:「表彰他在数值方法、自动编码系统与检错纠错码上的工作」。他自己对「做研究」这件事有一整套看法,1986 年 3 月 7 日在贝尔通信研究院讲的那一场《你和你的研究》是其中最有名的一次;而纠错码这个他亲手开出来的领域,站稳之后他故意不再读它的论文——「汉明,你不许再读这个方向的东西,你要去做别的」。

汉明肖像
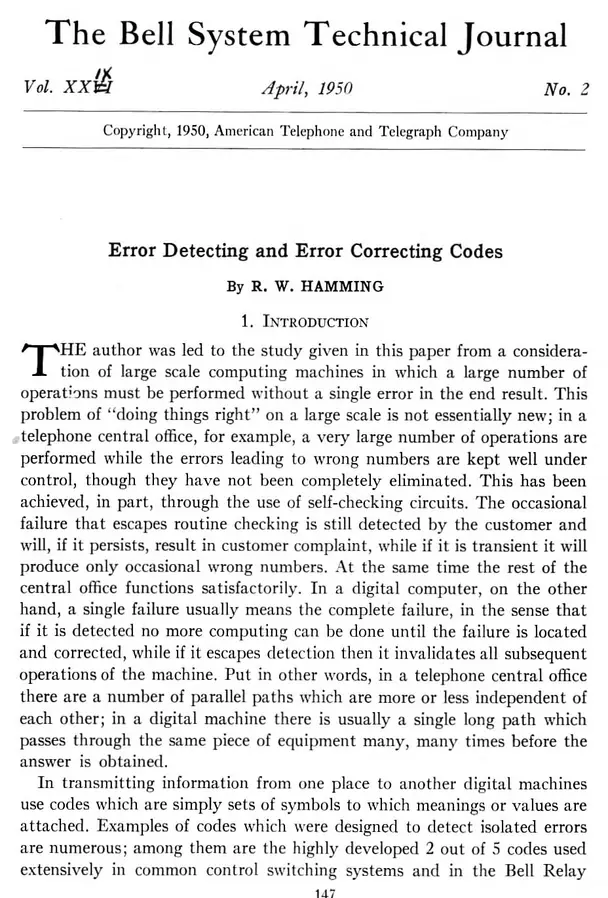
《贝尔系统技术杂志》第 29 卷第 2 号(1950 年 4 月)第 147 页 · 美国电话电报公司,公有领域(1950 年美国期刊,版权未续展)· Internet Archive。汉明没有一张够得上本馆尺寸下限的自由许可照片——维基百科用的那张标着「合理使用」,海军研究生院纪念页上那张比例正合适却只有 300 像素宽——所以这里放他自己留下来的那一页:《检错码与纠错码》的首页,篇名底下印着 By R. W. HAMMING。正文头一段说的就是他动手的缘由:在大机器上「把事情做对」,电话局靠的是许多条彼此独立的通路,而一台数字计算机只有一条长路,同一批器件要经过千万次,中间错一次,后面全作废

生平

  1. 1915年2月11日
    生于芝加哥

    伊利诺伊州。

  2. 1937
    芝加哥大学数学学士
  3. 1939
    内布拉斯加大学硕士
  4. 1942
    伊利诺伊大学博士

    论文《线性微分方程边值理论中的若干问题》,导师特日青斯基。做的是微分方程。

  5. 1945
    去洛斯阿拉莫斯

    管曼哈顿计划的计算机器。他自称是「跑腿的」,在那里见到费曼、费米、泰勒、奥本海默,上司是贝特。

  6. 1946
    进贝尔实验室

    刚去时与香农合用一间办公室:「同一段时间里他在做信息论,我在做编码论。」

  7. 1947–1948
    纠错码做出来

    机器夜里与周末无人看管地跑,查出错就把那道题扔下、接着做下一道。据汤普森 1983 年那本书所引的一段录音访谈,他说:「既然机器查得出有错,为什么不能指出错在哪儿、再把它改掉?」

  8. 1948
    香农那篇论文里的那两段

    《通信的数学理论》举了一个高效码的例子,注明出自汉明。这是他的码第一次见于印刷品——比他自己那篇早两年。

  9. 1949
    戈莱那一页纸

    《数字编码札记》,《无线电工程师学会会报》第 37 卷 657 页。给出两个完美码与第一个校验矩阵,比汉明自己那篇早一年。戈莱后来对梅西说,他当时所知的先前工作只有香农论文里的那两段。

  10. 1950年4月
    《检错码与纠错码》

    《贝尔系统技术杂志》第 29 卷第 2 号 147–160 页。第 5 节把码字放进 n 维立方体的顶点,定义了后来叫汉明距离的那个量;第 7 节证明第一部分那几族码在他的球堆积界下是最好的。

  11. 1956
    参与 IBM 650 与早期语言的工作

    他在贝尔实验室的工作横跨数值方法、操作系统与程序语言——图灵奖授奖词里的「自动编码系统」指的是这一摊。

  12. 1958
    那个以他命名的窗

    布莱克曼与图基《功率谱的测量》里的第三对窗,注明「有时叫作 hamming,取自 R. W. 汉明」,脚注指向他与图基一份从未发表的备忘录《测量噪声的颜色》。

  13. 1959
    稳定的预测-校正法

    《美国计算机学会会刊》第 6 卷 37–47 页。今天数值解常微分方程的教科书里仍叫汉明方法。

  14. 1962
    《科学家与工程师的数值方法》

    扉页那句「计算的目的是洞察,不是数字」出自这本书。

  15. 1968
    图灵奖

    授奖词:「表彰他在数值方法、自动编码系统与检错纠错码上的工作」——纠错码排在最后一项。

  16. 1970年10月
    《论数的分布》

    《贝尔系统技术杂志》第 49 卷第 8 号 1609 页起。从计算机的角度看浮点数尾数的分布,证明乘除法会把各种分布推向倒数分布。

  17. 1976
    离开贝尔实验室,去海军研究生院

    在蒙特雷教计算机科学,教到去世。

  18. 1977
    《数字滤波器》

    此后 1983、1989 两版。

  19. 1980年2月
    《数学不讲道理的有效性》

    《美国数学月刊》第 87 卷第 2 号 81–90 页。回应维格纳 1960 年那篇《数学在自然科学中不讲道理的有效性》。

  20. 1986年3月7日
    《你和你的研究》

    在贝尔通信研究院的讲演。他讲的不是怎么管理研究,是一个人怎么做自己的研究。

  21. 1988
    IEEE 设立汉明奖章
  22. 1998年1月7日
    卒于蒙特雷

    加利福尼亚州,八十二岁。距他从海军研究生院的讲台上下来不到一年。

展品厅

绝大多数展品都可以亲手把玩——这是本馆的立馆之本;少数以叙述为主的,做成故事展签。

镇馆之宝 · 亲手玩

把纠错变成几何:码字是立方体的顶点

在他之前,检错码是一条一条想出来的巧办法。他把所有码字摆进一个 n 维立方体,于是「能不能纠错」变成了「点与点隔得够不够远」。

D(x,y)=#{i:xiyi}D(x, y) = \#\{\, i : x_i \ne y_i \,\}

1950 年 4 月《贝尔系统技术杂志》第 29 卷第 2 号 147–160 页,第 5 节《一个几何模型》。在这一节之前,检错的办法是一条一条攒出来的:电话交换里的「五中取二」码、无线电报的「七中取三」码、电报末尾附的字数——每一种都是一个单独的巧思,彼此之间讲不出关系。他做的事只有一步:把一个 n 位的 0-1 串等同于 n 维单位立方体的一个顶点,整个码就是 2ⁿ 个顶点里挑出来的一个子集。然后在这个空间上装一个距离,「D(x, y) 定义为 x 与 y 不相同的坐标的个数」,而紧接着的那一句才是要害:「这与从 x 走到 y 最少要跨过几条棱是同一回事。」代数的定义与几何的走法,在这里被摁成了一件事。他随后逐条验了它确是一个度量:D(x,y)=0 当且仅当 x=y;D(x,y)=D(y,x)>0 当 x≠y;以及三角不等式。本馆把这三行与原刊逐字核过,发现第三行印错了一处:三角不等式的第一项印作 D(z, y),应作 D(x, y)。三条互相独立的判据。其一,按印本写的那样,左边由上一行刚给出的对称性等于 2D(y,z),取 y=z 就成了 0 ≥ D(x,z),只要 x 与 z 不同就是假的。其二,一个不等式的右边出现了左边完全没有的自由变量 x,形式上就不成篇。其三,同一页上 x 与 z 的字形判然有别,而前两行的 x 全部印对,可见不是字模混用;顺带一提,同一行右边那个 D 还误排成了正体,而前两行三个 D 都是斜体——这一行整体排得潦草。接着他给了一个例子:三维立方体里的 001、010、100、111,两两相距两个单位。六对距离本馆复算过,全是 2。有了距离就有了球:以 x 为心、半径 r 的球是所有与 x 相距 r 的点。于是整篇文章的主句可以一句话说完——码点之间的最小距离决定了这个码能做什么。他把它列成了表 V:最小距离 1 只保证唯一,2 能检一位错,3 能纠一位,4 能纠一位同时检两位,5 能纠两位。本馆按「最小距离 d 能检 d−1 位、能纠 (d−1)/2 的下取整位」复算,五行逐行吻合。他还点出一件容易被忽略的事:在同一个最小距离下,纠错的本事可以换成检错的本事——最小距离 5 的码可以用来纠两位,也可以用来纠一位加检三位,还可以纯用来检四位。这一步之后,「找一个好码」不再是灵机一动,而成了一个说得清的几何问题:在立方体的顶点里挑一批两两离得够远的点。今天汉明距离早已走出编码——拼写检查、生物序列比对、局部敏感哈希里用的都是它。

拨 n 看立方体长出来,点开任意两个码点量它们之间隔着几条棱;再把最小距离从 1 拨到 5,看表 V 那五行是怎么从「球碰不碰得着」推出来的

在他之前,检错码是一条一条想出来的巧办法——电话交换的「五中取二」、无线电报的 「七中取三」、电报末尾附的字数——彼此之间讲不出关系。1950 年那篇的第 5 节只做了一步: 把一个 n 位的 0-1 串看成 n 维立方体的一个顶点,再定义D(x, y) 为两者不同的坐标个数。紧接着那一句才是要害——「这与从 x 走到 y 最少要跨过几条棱是同一回事」。 画布上那条金色的路径就是在走棱:此刻不同的坐标有 3 个,而路径走了 3 条棱,两个数永远相等。有了距离就有了球, 于是「这个码能纠几位错」变成了「码点之间隔得够不够远」,也就是下面那张表 V; 而「找一个好码」从灵机一动变成了一个说得清的几何问题: 在立方体的顶点里挑一批两两离得够远的点。 原刊这一页上他还顺手指出,同一个最小距离下纠错的本事可以换成检错的本事: 最小距离 5 可以用来纠两位,也可以纠一位加检三位,还可以纯用来检四位。顺带记一处原文印错:这一页上度量三条件的第三行, 三角不等式的第一项印作 D(z, y),应作 D(x, y)——照印本那样写, 由上一行的对称性左边就等于 2D(y, z),取 y = z 便成了 0 ≥ D(x, z), 而右边还出现了左边根本没有的 x。

球堆得满不满:他的界与完美码

每个码字四周要留出一个不许别人进来的球。球的总体积不能超过整个空间——这一句就把所有纠错码的效率钉死了上界。

2mi=0t(ni)2n2^m \sum_{i=0}^{t} \binom{n}{i} \le 2^n

同一篇的第二部分,第 7 节。第一部分给出了三族具体的码,第二部分要回答的是另一个问题:它们是不是最好的。论证只有一行几何。若一个码能纠 t 位错,那么以每个码字为心、半径 t 的球两两不许相交,否则落在交叠处的那个收到的串就说不清该往哪边纠。球里有多少个点是数得出来的:与球心相距 i 位的点有 n 取 i 个,于是半径 t 的球含有 i 从 0 加到 t 的二项式系数之和。所有球加起来不能超过 2ⁿ,这就是今天叫作汉明界或球堆积界的那一行。纠一位的情形最干净:球里只有球心和它的 n 个近邻,共 n+1 个点,于是 2ᵏ ≥ n+1,校验位的个数 k 必须够写下 n+1 种情形——这正是他在第 3 节里用「校验数要能指出错在第几位,外加一个表示没错」凑出来的那个条件,两条路殊途同归。原刊第 151 页的表 I 把给定 n 时最大的 m 逐行列了出来,本馆按这个界复算了十六行,m 与 k 两列逐位相同,一处不差。真正有意思的是等号:球把空间填得一点缝也不剩的码,今天叫完美码。纠一位的完美码要求 2ᵏ = n+1,也就是 n = 2ᵏ−1,这给出一整族。而它们不是全部——这里要把首创权说清楚。戈莱 1949 年在《无线电工程师学会会报》第 37 卷第 657 页上发表了一页纸的《数字编码札记》,比汉明自己那篇早一年,里面有两个汉明这一族之外的完美码:二元的 (23, 12)、最小距离 7,与三元的 (11, 6)、最小距离 5;那一页还给出了汉明码的非二元推广,以及印刷品上第一个校验矩阵。梅西 1990 年给他写的讣告里记着一句戈莱亲口说的话:他动手时所知的先前工作,只有香农 1948 年那篇论文里描述汉明码的那两段。也就是说次序是这样的——汉明 1947 到 1948 年做出来,香农 1948 年在论文里用了并注明出处,戈莱 1949 年先发表了推广,而汉明自己那篇拖到 1950 年才登出来。本馆把戈莱那两个码代进球堆积的等式核过:二元那个半径 3 的球含 1+23+253+1771 = 2048 = 2¹¹ 个点,乘上 2¹² 个码字正好是 2²³;三元那个半径 2 的球含 1+22+220 = 243 = 3⁵ 个点,乘上 3⁶ 正好是 3¹¹。两边都是严丝合缝的等号。戈莱在那一页纸里顺带写下他相信完美码已经找全了,而这句话被此后二十年许多第一流数学家的工作最终证实。

第一部分给出了三族具体的码,第二部分要回答的是另一个问题:它们是不是最好的。 论证只有一行几何——能纠 t 位错,就等于说以每个码字为心、半径 t 的球两两不许相交, 否则落在交叠处的那个串说不清该往哪边纠。球里有多少个点是数得出来的, 于是所有球加起来不能超过 2 的 n 次方。 纠一位的情形最干净:球里只有球心和它的 n 个近邻,共 n+1 个点, 这正是他在第 3 节里用「校验数要指得出错在第几位,外加一个表示没错」凑出来的同一个条件。 此刻这一档:球有 8 个点,界允许 16 个码字, 占掉整个空间的 100.00%。填满的那几档叫完美码,画布上是金色的点。 纠一位的完美码就是汉明这一族;而它们不是全部—— 戈莱 1949 年那一页纸《数字编码札记》比汉明自己那篇早一年, 里面有两个汉明族之外的完美码:二元的 (23, 12) 与三元的 (11, 6), 还给出了印刷品上第一个校验矩阵。梅西 1990 年为他写的讣告里记着戈莱亲口说的一句话: 他动手时所知的先前工作,只有香农 1948 年论文里描述汉明码的那两段。 次序因此是清楚的:汉明 1947 到 1948 年做出来,香农 1948 年用了并注明出处, 戈莱 1949 年先发表了推广,汉明自己那篇 1950 年才登出来。

0.54 与 0.46 是怎么定出来的

做频谱分析要先把一段信号「开窗」,而窗的形状决定了假信号有多大。那个以他命名的窗,他本人一篇论文也没为它发表过。

u2=a2a1    a=2546=0.5434u^2 = \frac{a}{2a-1} \;\Longrightarrow\; a = \frac{25}{46} = 0.5434\ldots

这一件的一手文献不是他的论文,因为不存在这样一篇论文。布莱克曼与图基 1958 年的《从通信工程的角度测量功率谱》分两部分登在《贝尔系统技术杂志》第 37 卷 185–282 页与 485–569 页(次年由多佛出版社印成单行本)。第二部分列了四对窗,第三对底下印着一行:「有时叫作 hamming,取自 R. W. 汉明」,而那个脚注指向的第 26 号文献是「R. W. 汉明与 J. W. 图基,《测量噪声的颜色》,未发表的备忘录」。第一部分末尾的鸣谢里又单独谢了汉明「持续而积极的讨论,尤其是在计算与表述方面的讨论」。所以这个窗的归属要分三层说清:形状是他的,发表在别人的书里,而那份备忘录本身从未发表。馆里这一族情形已经见过几种——以他命名而不是他先做的,是他先做的而证明是别人补的——这是第四种。窗本身长这样:在相关函数那一侧,D(τ) = 0.54 + 0.46 cos(πτ/T),|τ| 不超过 T,此外为零;折到频谱那一侧就是把邻近三格按 0.23、0.54、0.23 加权平均,0.23 正是 0.46 的一半。今天的教科书多写成 0.54 − 0.46 cos(2πn/(N−1)),那是把窗架在数据上而不是架在延迟上,差的只是一个相位。那么 0.54 从哪儿来?把上面那个窗的谱算出来,用 sinc 把三项并到一起,可以化成一个很干净的形状:sin(πu)/π 乘上方括号 a/u − (1−a)u/(u²−1),其中 u 是折算过的频率。方括号为零的条件解出来是 u² = a/(2a−1)。矩形窗的旁瓣峰大致落在半整数上,而升余弦窗的主瓣要宽一倍,第一个旁瓣的峰因此落在 u = 2.5 附近。要让这个旁瓣被摁到零,代进去解 a:6.25 = a/(2a−1),得 a = 25/46 = 0.543478…,而 1−a = 21/46 = 0.456521…。0.54 与 0.46 就是这两个分数取两位小数。本馆复算时撞上一件没想到的事:四舍五入之后并不是将就,在「最高旁瓣」这个指标上它反而更好。取 25/46 时第一个旁瓣精确为零,最高的旁瓣退到远处、为主瓣的 −41.69 分贝;取 0.54 时第一个旁瓣不再是零(约 −9.7×10⁻⁴),可远处那一串旁瓣整体更低,最高的只有 −42.68 分贝,低了约 1 分贝。原因在方括号的远场:u 大时它趋于 (2a−1)/u,而 2×0.54−1 = 0.08 比 2×(25/46)−1 = 2/23 ≈ 0.08696 小了百分之八。逐个旁瓣比下来,只有最靠里的那一个是 25/46 更低,从第三个起每一个都是 0.54 更低。顺带记一件原文里的事:紧跟着的第四对窗,原文注着「RBB 并不太认真的一个提议」——那正是后来教科书上的布莱克曼窗。

做频谱分析要先把一段信号截出来,而截断本身会造出假信号——截口越硬, 旁瓣越高,一个强分量会在整条谱上撒出一片虚假的小峰。 窗就是用来把截口磨软的,而这个窗的形状只有一个参数 a。那么 0.54 从哪儿来?把窗的谱化简,可以写成 sin(πu)/π 乘上方括号 a/u − (1−a)u/(u²−1);方括号为零的条件解出来是 u² = a/(2a−1)。 升余弦窗的主瓣比矩形窗宽一倍,第一个旁瓣的峰因此落在 u = 2.5 附近, 要把它摁到零,代进去解得 a = 25/46 = 0.543478…,1−a = 21/46 = 0.456521…——0.54 与 0.46 就是这两个分数取两位小数。 复算时撞上一件没想到的事:四舍五入之后并不是将就。 取 25/46 时第一个旁瓣精确为零,最高的旁瓣退到远处、为 −41.69 dB; 取 0.54 时第一个旁瓣不再是零(约 −9.7×10⁻⁴),可远处那一串整体更低, 最高的只有 −42.68 dB。原因在方括号的远场:u 大时它趋于 (2a−1)/u, 而 2×0.54−1 = 0.08 比 2×(25/46)−1 ≈ 0.08696 小了百分之八。 逐个旁瓣比下来,只有最靠里的那一个是 25/46 更低,从第三个起每一个都是 0.54 更低。 最后要说清归属:这个窗以他命名,而他本人一篇论文也没为它发表过。 它出现在布莱克曼与图基 1958 年那部书里,原文写着「有时叫作 hamming,取自 R. W. 汉明」, 脚注指向的是他与图基一份从未发表的备忘录《测量噪声的颜色》。

浮点数的首位数字不是均匀的

一堆「自然出现」的数,首位是 1 的差不多占三成,是 9 的只占不到五分之一成。他要问的不是为什么,而是:机器算着算着,会把数推向哪种分布。

r(x)=1xlnb,P(首位=d)=log10 ⁣(1+1d)r(x) = \frac{1}{x \ln b}, \qquad P(\text{首位}=d) = \log_{10}\!\left(1+\frac{1}{d}\right)

1970 年 10 月《贝尔系统技术杂志》第 49 卷第 8 号 1609 页起,《论数的分布》。开篇那句写得很有分寸:这篇要从计算机的角度,来看那件「为数不多的人才知道」的事——浮点数尾数的分布并不均匀。经验上它贴近倒数密度 r(x) = 1/(x ln b),b 是进位制的底。这个观察本身比他早得多,纽康 1881 年、本福特 1938 年都记过;他自己在文中说这个分布「已经被人用许多种方式解释过」。他做的是另一件事:不问这些数一开始从哪儿来,只问机器的四则运算会把分布搬到哪里去。结论是倒数分布是乘除法的不动点,而且是个吸引子——两个数相乘,只要其中一个的尾数服从倒数分布,乘积的尾数就服从倒数分布,跟另一个是什么分布无关;一个数取倒数,尾数仍服从这个分布。于是无论一批数最初怎么分布,只要在机器里连乘几轮,尾数就朝这条曲线塌过去。他还顺手把这件事推到了硬件与软件上:尾数的分布不均匀意味着移位规格化的次数可以预估,浮点乘法的溢出概率、舍入误差的统计都跟着变;而这一点「不只是一件好玩的怪事」。本馆核过这条密度的几个数:它在 1/b 到 1 上积分为 1;首位数字是 d 的概率等于 log₁₀(1+1/d),从 1 到 9 依次是 0.3010、0.1761、0.1249、0.0969、0.0792、0.0669、0.0580、0.0512、0.0458,九项相加为 1。首位是 1 的概率约是首位是 9 的六点六倍。要提一句分寸:这条分布不是定理而是经验规律加上不动点性质,它对「自然出现」的数成立,对身份证号、电话号码这类人为编号并不成立——他在文中把成立的范围说得很清楚,本馆这一件也只讲他讲过的那一半。

一堆「自然出现」的数,首位是 1 的差不多占三成,首位是 9 的不到五分之一成—— 这件事纽康 1881 年、本福特 1938 年都记过,汉明自己在文中也说它「已经被人用许多种方式解释过」。 他 1970 年那篇要做的是另一件事:不问这些数一开始从哪儿来,只问机器的四则运算把分布搬到哪儿去。 答案是倒数密度 1/(x ln b) 不但是乘除法的不动点,而且是个吸引子: 两个数相乘,只要其中一个的尾数服从它,乘积就服从它,跟另一个是什么分布无关。 画布上那四个起始分布,没有一个像它——全一样的四千个 3.7,甚至只有一根柱子—— 可只要把滑块往右拨几格,直方图就一路朝那条金线塌过去; 此刻首位分布与 log₁₀(1+1/d) 的最大偏差是 0.1865。 他把这件事一路推到硬件与软件上:尾数分布不均匀,意味着规格化移位的次数可以预估, 浮点乘法的溢出概率、舍入误差的统计都跟着变,所以它「不只是一件好玩的怪事」。 要提一句分寸:这不是定理,是经验规律加上不动点性质, 它对自然出现的数成立,对身份证号、电话号码这类人为编号并不成立。

再加一位,就多一种本事

一个能纠一位错的码,末尾添一个管全局的校验位,立刻变成「能纠一位、并且看得出什么时候错了两位」。今天每一条服务器内存都在用这一招。

d=3    +总校验位    d=4d = 3 \;\xrightarrow{\;+\text{总校验位}\;}\; d = 4

同一篇的第 4 节。前一节给出的码最小距离是 3,按表 V 它能纠一位;可它有个要命的脾气:一旦真错了两位,它不会告诉你,它会若无其事地「纠」到第三个码字上去,把两位错变成三位错。他的补法只有一句:在末尾再添一位,让整个码字的 1 的个数成偶数。这一位为什么管用,用距离说最清楚。原来两个码字若相距 3(奇数),它们 1 的个数的奇偶必不相同,于是新添的那一位也必不相同,距离就变成 4;原来相距 4 或更远的,添一位只会不减。所以新码的最小距离恰好是 4。而按表 V,最小距离 4 正是「纠一位错,同时检两位错」。分辨的办法也干净:收到一个串,先看那个总校验位对不对,再看指错的校验数是不是零。两个都对,没错;总校验位不对,是一位错,校验数指着它,改掉;总校验位对而校验数不为零,那就是两位错——纠不了,但知道自己纠不了,于是可以喊停、可以重发。这最后一句才是它在工程上的全部价值:一个会声张的错误远比一个不声不响被改坏的结果便宜。本馆按这条构造列了一串:(7,4) 加一位成 (8,4),冗余 2.0000;(15,11) 成 (16,11),1.4545;(31,26) 成 (32,26),1.2308;(63,57) 成 (64,57),1.1228;(127,120) 成 (128,120),1.0667;(255,247) 成 (256,247),1.0364。信息位越多,多带的那几位就越不值一提。今天服务器内存里的 ECC 走的正是这一路:把 64 位数据配 8 位校验凑成 72 位,纠一位、检两位,业内的叫法就是 SEC-DED。它不是那一族完美码里的任何一个——为了凑成 64 这个整数,码被截短过——但构造的道理就是 1950 年这一节的四行字。

第 3 节那个码最小距离是 3,按表 V 它能纠一位;可它有个要命的脾气——一旦真错了两位,它不会告诉你,它会若无其事地「纠」到第三个码字上去, 把两位错变成三位错。他的补法只有一句:在末尾再添一位,让整个码字里 1 的个数成偶数。 为什么这一位管用,用距离说最清楚:原来相距 3(奇数)的两个码字, 1 的个数的奇偶必不相同,于是新添的那一位也必不相同,距离变成 4; 原来相距 4 或更远的,添一位只会不减。所以新码的最小距离恰好是 4, 而按表 V,最小距离 4 正是「纠一位,同时检两位」。 分辨的办法也干净:先看总校验位过不过,再看校验数是不是零。 两项都过,没错;总校验不过,是一位错,校验数指着它;总校验过而校验数不为零,那就是两位错——纠不了,但知道自己纠不了。 画布上把两个滑块都拨开试试:翻一位时两边都纠得回来, 翻两位时左边把结果改得更坏,右边把手举起来。 最后这一句才是它在工程上的全部价值:一个会声张的错误,远比一个不声不响被改坏的结果便宜

他为什么要研究别人怎么做研究

在洛斯阿拉莫斯,他管机器,别人做物理。他说自己是个跑腿的,而且嫉妒——「我想知道他们究竟跟我有什么不一样」。

1986 年 3 月 7 日,他在贝尔通信研究院讲了一场,题目是《你和你的研究》。开头他先把题目划清楚:这不是讲怎么管理研究,是讲你自己怎么做你的研究;而且讲的不是一般的研究,是那种「诺贝尔奖级别」的工作。接着他交代了这项「研究」的由来,而这一段是全篇最坦白的:在洛斯阿拉莫斯,他被叫去管那些别人已经弄起来的计算机器,好让科学家和物理学家回去做正事。「我看出自己是个跑腿的。我看出,虽然肉体上我和他们一样,他们却是不同的。说得直白点:我嫉妒。我想知道他们为什么跟我不一样。」他在那里近距离看过费曼、费米、泰勒、奥本海默,以及他的顶头上司贝特。到了贝尔实验室,他进的又是一个高产的部门——博德是部门主管,香农在那里——于是他接着问同一个问题,并且开始读传记、读自述,逮着人就问「你当初是怎么想到去做这件事的」。讲演里有几处后来被反复引用。一处是博德跟他说的复利:知识与产出像复利,两个能力相当的人,其中一个每天多干一成,一辈子下来产出会多出一倍不止。一处是开着门与关着门:关着门的人今天明天干得更多,可十年之后往往不大清楚什么问题值得做;开着门的人不断被打断,却总能零零碎碎地听见这世界正在发生什么、什么可能要紧。还有一处是他自己的办法——在图基等人的怂恿下,他把每个星期五下午定成「大问题时间」,那半天只许想大问题:计算机将在整个 AT&T 里扮演什么角色,计算机会怎么改变科学。他当时说十个实验有九个在实验室做、一个在计算机上做,将来会倒过来;副总裁们觉得这个疯疯癫癫的数学家没有现实感。最后还有一件事值得记在他自己名下:纠错码这个他亲手开出来的领域,站稳之后他对自己下了禁令——「汉明,你不许再读这个方向的论文,你要去做别的」——为的是不在自己的名声上吃老本。这一件是故事展签,没有演示:它记的不是一条定理,是一个管机器的人决定去研究那些做物理的人。

故事展签

传承

他的工作没有留在十八世纪——每条链的终点,都是你今天正在使用的东西。

把码字放进 n 维立方体、用最小距离量纠错能力线性分组码、循环码、BCH 与里德–所罗门码二维码、光盘、深空探测与 5G 的信道编码都从这套语言开始讲
球堆积界与完美码戈莱码与完美码的分类旅行者号靠戈莱码把木星的照片发回来,深空探测至今用它;而球堆积与格一路通到今天的格密码学
纠一位加检两位的构造SEC-DED 校验电路服务器与航天器内存里的 ECC,每一次读写都在跑它
0.54 与 0.46 那个窗加窗的功率谱估计与数字滤波器设计语音识别的每一帧、手机基带的每一次频谱分析都要先加一次窗
浮点尾数的倒数分布是乘除法的不动点浮点运算的误差统计与规格化次数估计数值逼近里的误差估计,以及拿首位数字分布去查账户余额与报表上的造假
《你和你的研究》里那套「开着门工作」工业实验室与大学里关于研究选题的通行说法工业实验室怎么挑题、怎么排资源,成了一件被认真讨论的事——今天讲科研最优化与选题的课,十有八九还在放这一篇

他在哪几条专题里

专题是按技术组织的演进线,一条从概念提出拉到今天的器物。这里一个字都没手写, 全是 tracks.ts 推出来的。

语录

计算的目的是洞察,不是数字。

—— 《科学家与工程师的数值方法》扉页,1962

既然机器查得出有错,为什么不能指出错在哪儿、再把它改掉?

—— 据汤普森《从纠错码到球堆积到单群》1983 所引的一段录音访谈。他自己在 1950 年那篇里给的是技术版的说法:机器在夜里与周末无人看管地跑,出错就把那道题扔下、接着做下一道

我看出自己是个跑腿的。我看出,虽然肉体上我和他们一样,他们却是不同的。说得直白点:我嫉妒。

—— 《你和你的研究》,贝尔通信研究院讲演,1986 年 3 月 7 日;说的是在洛斯阿拉莫斯管计算机的那段日子

关着门的人今天明天干得更多,可十年之后,他不大清楚什么问题才值得做。

—— 同上。原话是就「开着门工作」与「关着门工作」两种人作的对比,他自己说这只是很强的相关,因果他证不了