John W. Tukey · 1915–2000

图基

他与库利把 N 个数的傅里叶变换从 N² 次乘加压到 2N·log₂N 次——那一招高斯早写过,要等有了计算机才用得上;后半生教人先看数据、再谈模型:从两头往里数,数出中位数、铰链与箱线图

T=N(r1+r2++rm),N=r1r2rmT = N\,(r_1 + r_2 + \cdots + r_m), \qquad N = r_1 r_2 \cdots r_m
库利与图基 1965 年那篇的 (9)(10) 式:把 N 拆成 m 个因子,变换只要 N 乘因子之和那么多次乘加,而不是 N²。N 是 2 的 m 次方时,就是 2N·log₂N

约翰·怀尔德·图基 1915 年 6 月 16 日生于马萨诸塞州的新贝德福德。父母都是中学的古典语文教师,他没有上过中学,书是母亲在家里教的,镇上的公共图书馆里有化学与数学的期刊。他在布朗大学念的是化学,1936 年学士、次年硕士,1937 年到普林斯顿本想接着读化学的博士,一年之内转到了数学,1939 年在莱夫谢茨门下以一篇拓扑的论文取得博士,次年印成《拓扑中的收敛与一致性》。战时他进了普林斯顿的火控研究办公室,算弹道、测距与移动目标的提前量,从此转向统计。1945 年起他同时在普林斯顿与贝尔实验室两边任职;1965 年普林斯顿成立统计系,他是第一任系主任。2000 年 7 月 26 日卒于新泽西,八十五岁。

他名下最常被引的是 1965 年与库利合写的那五页:把 N 个数的傅里叶变换拆成一串小变换,乘加从 N² 次降到 2N·log₂N 次。今人考证出高斯 1805 年前后就写过同一招,只是生前没有发表;这篇之所以成了起点,是因为它登出来的时候正好有机器可以跑它。他自己更看重的是数据分析:先把一批数摊开来看,再决定用什么模型——中位数与铰链、箱线图、茎叶图都是他在普林斯顿的课上一样样教出来的,1971 年先印成三卷讲义,1977 年正式出版。他造词成癖,「比特」这个词是他向香农建议的,香农 1948 年那篇的脚注里记着。拓扑出身也留下了一条今天叫图基引理的命题(有限特征的集族有极大元,与选择公理等价;泰希米勒 1939 年独立给出过),在他 1940 年那本书里。

图基肖像
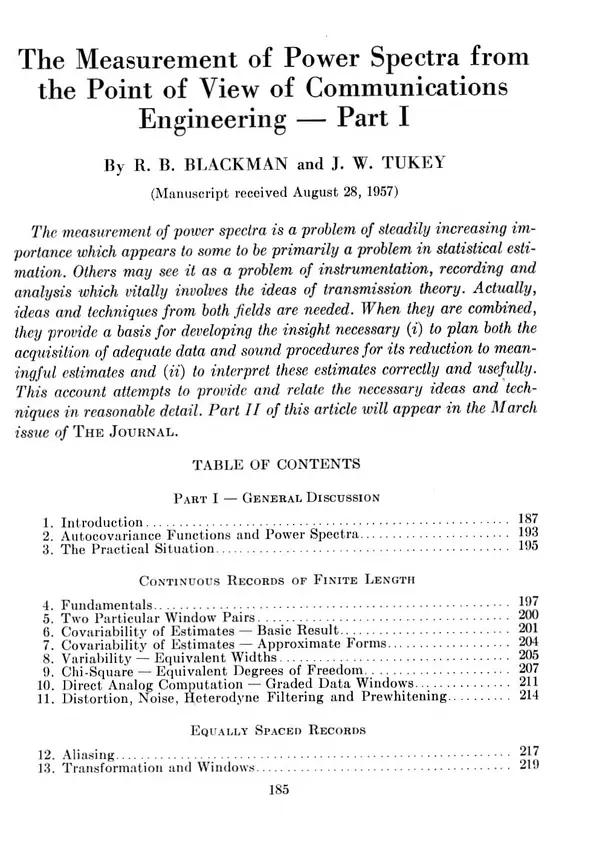
《贝尔系统技术杂志》第 37 卷第 1 期(1958 年 1 月)第 185 页 · 美国电话电报公司,公有领域(1958 年美国期刊,版权未续展)· Internet Archive。图基没有一张许可合用的照片,所以这里放他自己的一页:他与布莱克曼《从通信工程的角度测量功率谱》上篇的首页,篇名底下印着 By R. B. BLACKMAN and J. W. TUKEY 与收稿日 1957 年 8 月 28 日。摘要第一句说,功率谱的测量在一些人看来首先是统计估计的问题,在另一些人看来是仪器、记录与传输的问题,其实两边都要。汉明窗就是在这篇的下篇里印进文献的

生平

  1. 1915年6月16日
    生于马萨诸塞州新贝德福德

    父母都是中学的古典语文教师。他没有上过中学,由母亲在家教。

  2. 1936–1937
    布朗大学化学学士、硕士

    1937 年去普林斯顿,本打算读化学的博士。

  3. 1939
    普林斯顿数学博士

    导师莱夫谢茨,论文讲拓扑里的可数性;次年印成《拓扑中的收敛与一致性》。

  4. 战时
    火控研究办公室

    战时在普林斯顿算弹道、测距与移动目标的提前量,从此转向统计。

  5. 1945
    普林斯顿与贝尔实验室两边任职

    1946 年前后在罗格斯的美国数学会年会上,瓦尔特·迈尔听说他要留在贝尔实验室,很是吃惊。

  6. 1948
    「比特」

    香农《通信的数学理论》第一次把这个词印出来,脚注里写明是图基建议的。

  7. 1958年1月
    《功率谱的测量》

    与布莱克曼合写,分两期登在《贝尔系统技术杂志》第 37 卷。本页的图就是它的首页。

  8. 1964年8月17日
    库利–图基那篇收稿

    《复傅里叶级数的机器计算算法》,次年 4 月登在《计算数学》第 19 卷第 297–301 页,致谢里谢了理查德·加温。

  9. 1965
    普林斯顿统计系的第一任系主任

    做了四年。

  10. 1971
    《探索性数据分析》有限预印本

    三卷,普林斯顿大学书店发售,由 1968 年起统计学 191 课的讲义长成。箱线图已经在第五章里。

  11. 1974年8月
    温哥华,《数学与数据的图示》

    国际数学家大会上的报告,次年印在会议录第二卷第 523–531 页:铰链的深度、第 i 个数该配的分数、平面上的深度都在这一篇。

  12. 1977
    《探索性数据分析》正式出版

    艾迪生–韦斯利出版社。

  13. 2000年7月26日
    卒于新泽西

    八十五岁。

展品厅

绝大多数展品都可以亲手把玩——这是本馆的立馆之本;少数以叙述为主的,做成故事展签。

镇馆之宝 · 亲手玩

把 N² 次乘加拆成 2N·log₂N 次

N 拆成两个因子,下标写成两位数,双重求和就能一位一位地求;一直拆到 2,一万个点的变换只要照直算的几百分之一。这一招高斯写过,他们登出来的时候,正好有机器可以跑它。

1965 年 4 月的《计算数学》第 19 卷第 297–301 页,库利与图基的《复傅里叶级数的机器计算算法》只有五页。问题一行写得完:给 N 个复数 A(k),要算 X(j) = Σ A(k)·W 的 jk 次方,W 是 1 的 N 次本原根。照直算,每个 X(j) 要 N 次乘加,一共 N² 次。他们的办法是把 N 拆成 r₁·r₂,把下标 j、k 都写成两位「数字」,那个求和就能先对一位求、再对另一位求:先 N·r₁ 次,再 N·r₂ 次,合计 N(r₁ + r₂)。一直拆下去,N = r₁r₂⋯r_m 时只要 N(r₁ + ⋯ + r_m) 次;N 是 2 的 m 次方时是 2N·log₂N 次,文中说实际还用不了这么多。按二进制拆时,结果的下标要把各位倒过来读,整个计算就在存原数据的那 N 个位置里做完,不用多一块存储。文末是 IBM 7094 上的计时:2 的 13 次方即 8192 个点,最慢的一种排法用了 0.13 分钟。照直算要 8192² 约 6711 万次,这里是 21.3 万次,差 315 倍。致谢里他们感谢理查德·加温「在沟通与鼓励上的关键作用」。这一招不是他们最先想到的。高斯为从观测插值小行星的轨道写过一篇《用新方法处理的插值理论》,生前没有发表,1866 年收进全集第三卷第 265 页起,编者在卷末注里说它的初稿「似乎始于 1805 年 10 月」;今人考证(海德曼、约翰逊与伯勒斯 1984)指出,里面用的正是把长度拆成因子、分步求和的同一招。二十世纪又有龙格 1903 年的倍长格式、丹尼尔森与兰乔什 1942 年的办法;库利与图基自己在开头引的是耶茨的析因试验算法与古德 1958 年的一篇。

拖 m 看 N = 2 的 m 次方时两种算法差多少;按「下一级」看八个点的蝶形图一级一级地合

N = 1024 时照直算要 1,048,576 次乘加,按二拆只要 20,480 次,省下 51.2;N 每翻一倍,这个倍数也差不多翻一倍。

形式上三最省,可大家都按二拆

按 r 拆一次,每个数要花 r 次;拆完 log_r N 层,总账是 r / log₂ r 乘 N·log₂N。这个比在 r = 3 最小,可他们劝人用 2 或 4——原文那张表里,带因子 3 的三格都印小了一点。

同一篇的第 298、299 页算了一笔账。N 是 r 的 m 次方时,总次数是 r·N·log_r N,除以 N·log₂N 得 r / log₂ r;N 拆成好几种因子时,这个比是各个 r / log₂ r 按位数加权的平均。他们还说了两件事:一个因子若能再拆,拆开总不吃亏(s + t 不超过 s·t),只有 2·2 = 4 拆不拆一样,所以因子越多越好,到素数为止;而 N 若是素数,这一招一点用不上——N = 1009 时比值是 101,与照直算无异。他们列了 r 从 2 到 10 的一张表,接着写:「用 r = 3 形式上最省,但比用 2 或 4 只省约 6%,而 2 和 4 另有好处」——在二进制的机器上,寻址与乘法都占便宜。所以今天几乎所有的快速傅里叶变换都按 2 或 4 拆。这张表可以逐格复算。九格里六格一位不差;含因子 3 的三格,r = 3、6、9,印作 1.88、2.31、2.82,今算是 1.89、2.32、2.84,三格都偏小。而且偏得一致:只要把 log₂3 取成 1.593 到 1.599 之间的一个数,三格同时对上,而 log₂3 的真值是 1.585。看来算这三格时 log₂3 用了一个偏大的近似值;是哪个近似、怎么来的,原文没有交代。结论不受影响:3 仍是最省的,按真值比 2 省 5.7%,「约 6%」照样成立。他们因此劝人把 N 选成「高度合成」的数,并说在任何一个大数附近几个百分点之内总找得到。

N = 1000:素因子之和 21,比值 2.1072比照直算省 47.6

从两头往里数:五个数与一个盒子

一个数的深度是从较近的一头数进来排第几;中位数与两个铰链只靠数数就定得出来,一局打坏了的比赛也拉不动它们。

《探索性数据分析》1977 年才正式出版,可它有一个早六年的版本:1971 年普林斯顿大学书店卖的三卷「有限预印本」,由 1968 年起统计学 191 课的讲义长成,每章首页印着「不得再复制」。第四章拿一位保龄球手最近十局的得分当例子:193、214、185、198、203、207、191、184、210、192。第二章教的办法是从两头往里数。一个数的深度,是从较近的一头数进来排第几;中位数的深度是(1 + 个数)÷ 2,十个数是 5.5,取第五、第六个的平均 195.5;铰链的深度是(1 + 中位数深度的整数部分)÷ 2,这里是 3,从下往上第三个是 191,从上往下第三个是 207。两个极端 184 与 214,加上中位数与两个铰链,就是他的五数概括。第五章把它画成一个盒子:两端在铰链,中间一道横线是中位数,两根须伸向极端——这就是箱线图。接着要问哪些点离群得值得单独看。1971 年的讲义先在两个铰链外各放出一个铰链距(这里是 16),叫旁值,出了这条线的叫「在外」;要再分出走得太远的,本可以在旁值外再放一个铰链距,他说试下来太严,就折个中,在铰链外放一倍半,出了这条线的叫「脱离」。今天通行的画法把 1.5 倍放在里面那一道、3 倍放在外面那一道——同一个 1.5,在 1971 年的讲义里是外面那一道。为什么不用均值与标准差:这十局的均值 197.7,要是第二局不是 214 而是 300,均值就被拉到 206.3,中位数与两个铰链一动不动。第二章开头就说过,不该指望一个标准的概括去揭示异常,那是图的事。

第二局 214 分:在界内。均值 197.7中位数 195.5、铰链 191207——只要这一局还是最高分,它们就一动不动。

第 i 个数,该配哪个分数

n 个数排好序,第 i 个对应的累积比例,教科书上有 (i − 1/2)/n 与 i/(n + 1) 两种。他取的是一个分布的中位数,得出的是 (i − 1/3)/(n + 1/3)。

1974 年 8 月,图基在温哥华的国际数学家大会上作了一场报告,题目是《数学与数据的图示》,次年印在会议录第二卷第 523–531 页。第 5 节问了一个看上去很小的问题:一批 n 个数排好序,第 i 个该对应哪个累积比例?画概率图要用它,把一批数和正态分布对着看也要用它。教科书上有两种答案,(i − 1/2)/n 与 i/(n + 1)。他换了一个问法:从一个连续分布里抽 n 个,第 i 小的那个的累积分布值,其分布只依赖 n 与 i,与原来那个分布无关;这个分布的位置用它的中位数来代表最好,因为取中位数与任何单调的变换可以交换次序。他查贝塔分布或 F 分布的表得出,这个中位数很接近 (i − 1/3)/(n + 1/3);又说 n 不小于 5 时对所有 i,换成 (i − 0.3)/(n + 0.4) 不等号就反过来。这些都可以现算。n = 10 时,(i − 1/3)/(n + 1/3) 的最大偏差是 0.0025,(i − 1/2)/n 是 0.017,i/(n + 1) 是 0.024,差七到十倍。「n 不小于 5」这个门槛是准的:n = 4 时 i = 1 那一格,精确的中位数 0.159104 比 0.7/4.4 = 0.159091 大 1.27e−5,夹不住;n 从 5 到 120 逐格都夹得住。只有一处要带分寸:他写的方向——中位数略小于 (i − 1/3)/(n + 1/3)——只对上半截即 i 大于 (n + 1)/2 成立,下半截恰好反过来。第 i 小与第 i 大本来互为镜像,一个不等号不可能对所有 i 同向。同一节里他还把经验分布函数改写成「严格小于的个数 + 相等的个数的一半 + 1/6」除以「n + 1/3」,在第 i 个数上正好是 (i − 1/3)/(n + 1/3)。

n = 10:图基那一种最大偏差 0.0025,(i − 1/2)/n 是 0.0170,i/(n + 1) 是 0.0239——小了 6.99.8

平面上的中位数:从每个方向数一遍

一维的中位数靠左右之分,平面上没有左右。他改问:一条直线把点分成两边,少的那边有几个?每个方向都数一遍,最少的那个数就是深度。

同一篇报告的第 7 节问:这一切怎么推广到平面上,而且是只认直线、不认长度与角度的仿射平面?他说次序统计量直接推广「一败涂地」。他的推广是把第 i 个次序统计量看成一个有方向的点——它左边连同它自己有 i 个数;到了平面上,就换成一条有方向的直线,看它左侧有几个点。每一个方向上恰好有一条「深度为 i」的直线,所有方向的这些直线围成一圈,圈里剩下一个多边形;他在图 2 里拿 11 个点画了这些多边形。今天通行的说法把它倒过来讲点:一个点的深度,是过这个点的每一条直线把平面分成两半,点少的那一半最少有几个点。深度最大的那一块的中心,就是平面上的中位数,今称图基中位数;这个深度也叫图基深度或半平面深度。它有两条好处,均值都没有。一是只认直线:把整张图拉伸、剪切、旋转,每个点的深度一个都不变,因为它只数「在直线哪一边」。二是扛得住坏点:演示里把一个点往外拖到很远,均值被拽着走,最深的那一块几乎不动。平面上总有深度至少为 n/3(向上取整)的点,这件事今天叫中心点定理。他在报告里说二维的那一圈「太复杂,不是一对次序统计量的满意推广」,于是又取两个多边形之间的中点连成一个新的多边形,那才是他要的「第 i 层」。从这里后来长出了多元鲁棒统计里讲「深度」的一整支。

把一个点往右拉了 0.0:均值跟着挪了 0.000最深处只挪了 0.000。格点上最深的深度是 4,中心点定理的下界是 n/3 向上取整 = 4

「我说一个 g_ik 有什么性质,它就有」

1946 年前后,一位拓扑学家在年会上惊讶地问他:你真要留在贝尔实验室?二十八年后他在国际数学家大会上讲了这件事,讲的是数学家走近数据时唯一的短处。

1974 年温哥华那篇报告一开头,图基先说为什么要讲这个题目:照眼下的势头,今后几十年里会有越来越多的数学家碰到、或者差一点碰到数据。数学家有许多长处——思路清楚,惯于一步一步从头推到尾,手里有各种数学结构,爱把一种技巧当零件装进另一种里,看得出细微的假设怎样造成大不同——「只有一个大短处:他对『假设』这个词的态度」。接着他岔开去讲一个故事,约在 1946 年。已故的瓦尔特·迈尔,那时是普林斯顿高等研究院数学学院的成员,与他在罗格斯大学开美国数学会年会时聊天。迈尔听说他要留在贝尔实验室、同时也留在普林斯顿大学,很是吃惊;他讲起自己一战时在德国怎样卷进了应用的事,后来回到纯数学又有多高兴,因为那里——图基说「我照原话引」——「我说一个 g_ik 有某些性质,它就有」。图基的评语只有一句:如果你不能偶尔改一改迈尔当时的这种态度,贴着数据的工作大概不是你的所长。他接着说:面对真实的数据时,形式化的模型不是数学家意义上的假设,而是参照的情形、是基准点,拿来与手上的数据比,看它差在哪里;既然没有哪个模型可以信,为单个模型求最优就只能给出远远的指引。迈尔就是拓扑里迈尔–菲托里斯序列的那一位。图基自己也是拓扑出身——1939 年的博士论文讲的是可数性,导师莱夫谢茨——战时进了火控研究办公室才转向统计,此后三十多年一直一脚在大学、一脚在贝尔实验室。这篇报告的第 2 节说,图最要紧的用处是揭示没有料到的东西;拿图去给心虚的人壮胆、证明刚找到的东西确实成立,是不要紧的用法,那种时候看一个概括就够了。

故事展签故事展签:一个拓扑学家的惊讶,和一个拓扑学家的回答。

传承

他的工作没有留在十八世纪——每条链的终点,都是你今天正在使用的东西。

1965:N 个点的傅里叶变换,从 N² 次乘加降到 2N·log₂N 次频谱分析、数字滤波第一次在机器上算得起,模拟的滤波器组一件件换成了程序手机里的 4G/5G 解调、MP3 与 JPEG 的编码、医学影像的重建,底下都是这一步信号处理
1965:按 2 或 4 拆,寻址是把二进制位倒过来读,运算就在原来那块存储里做完这一套成了硬件上固化的算法,数字信号处理器专门为它设了倒位寻址今天每一颗基带芯片与音频芯片里,都有一块专门跑这个算法的电路
1971:从两头往里数,五个数概括一批数,再画成一个盒子两根须箱线图进了每一种统计软件,成了比较几组数据的默认画法今天任何一份数据分析报告、一次 A/B 测试的结果,都少不了这张图
1974:第 i 个数配 (i − 1/3)/(n + 1/3),取的是一个分布的中位数概率图与分位数图拿它把一批数和正态分布对着看,歪在哪里一眼看出统计推断之前先查分布像不像,质量控制与实验数据的检查都照这一步做
1974:平面上一个点的深度,是过它的直线切下的点数最少的那一半多元的中位数与深度等值线成了鲁棒统计的一块基石,不怕少数坏点异常检测、机器学习里的离群样本清洗,都用得上这种「扛得住坏点」的中心
1974:模型不是假设,是拿来比的参照;图是用来揭示没有料到的东西探索性数据分析成了一门课:先看数据,再决定用什么模型大数据与机器学习的第一步,至今仍是把数据画出来看

他在哪几条专题里

专题是按技术组织的演进线,一条从概念提出拉到今天的器物。这里一个字都没手写, 全是 tracks.ts 推出来的。

语录

数学家走近数据时的大短处,是他——或她——对「假设」这个词的态度。

—— 《数学与数据的图示》,1974 年国际数学家大会(温哥华)会议录第二卷,1975,第 523 页 · 中译

面对真实的数据时,形式化的模型不是数学家意义上的假设,而是参照的情形——不妨叫它基准点——拿来与手上的数据比,看它差在哪里。

—— 同上,第 524 页 · 中译

图最擅长的,是揭示没有料到的东西。

—— 同上,第 524 页 · 中译

用 r = 3 形式上最省,但比用 2 或 4 只省约 6%,而 2 和 4 另有好处。

—— 库利与图基《复傅里叶级数的机器计算算法》,《计算数学》第 19 卷(1965),第 299 页 · 中译