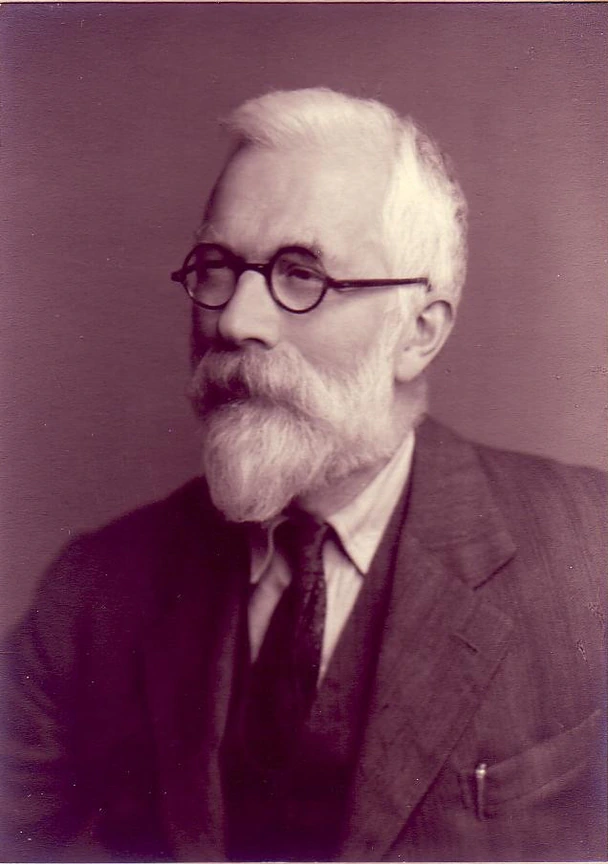
Ronald A. Fisher · 1890–1962

费希尔

他把「从一批数里能说出什么」变成了数学:给似然下定义,算出一个估计量最多能用上多少信息,把总方差拆成几份相加,又说明小区为什么要抽签来排——数理统计、实验设计与群体遗传学都从他这里起步;他也终身提倡优生学,晚年质疑吸烟致癌

I(θ)=1y(yθ)2dx,V(θ^)1nI(θ)\mathcal{I}(\theta) = \int \frac{1}{y}\left(\frac{\partial y}{\partial \theta}\right)^{2} dx, \qquad V(\hat\theta) \to \frac{1}{n\,\mathcal{I}(\theta)}
1925 年《统计估计理论》第 6 节:一次观测里含的信息量;大样本里,有效的估计量方差趋于 1/(nI)。独立观测的信息量可以相加

罗纳德·艾尔默·费希尔 1890 年 2 月 17 日生于伦敦,父亲是一家拍卖行的合伙人。1904 年进哈罗公学,1909 年进剑桥冈维尔与凯斯学院,1912 年数学荣誉考试毕业,接着跟天文学家斯特拉顿读误差理论,同年发表第一篇论文。毕业后他在伦敦一家投资公司当过统计员;一战时视力不合格,参不了军,1915 至 1919 年在几所中学教数学与物理。1919 年进哈彭登的罗瑟姆斯特德试验站,一待十四年。1929 年当选皇家学会会员;1933 年接替卡尔·皮尔逊任伦敦大学学院高尔顿优生学讲座教授,1943 年任剑桥阿瑟·鲍尔弗遗传学讲座教授,1952 年封爵。1959 年离开剑桥,移居澳大利亚阿德莱德,1962 年 7 月 29 日卒于那里。

他给统计学立了骨架:1922 年那篇把问题分成设定、估计、分布三类,定义了一致、有效、充分,给「似然」下了定义;1925 年的《研究工作者的统计方法》把小样本的检验与方差分析交到了做实验的人手里;1935 年的《实验设计》讲随机化、区组与拉丁方。他同时是群体遗传学的奠基人之一:1918 年那篇调和了孟德尔遗传与连续变异,1930 年出了《自然选择的遗传理论》。生平里有两件事要照实写。一是他终身提倡优生学:本科时就参与筹办剑桥大学优生学会,《自然选择的遗传理论》的后几章讲人类的生育率与文明的兴衰,他主张家庭津贴按收入比例发放,好让他眼中的「适者」多生育;他在伦敦大学学院坐的正是优生学讲席。2020 年,冈维尔与凯斯学院撤下了纪念他的彩色玻璃窗,伦敦大学学院也给一座以他命名的实验室改了名。二是晚年:1957 年起他在《英国医学杂志》与《自然》上接连撰文,质疑多尔与希尔等人由病例对照研究得出的「吸烟致肺癌」,提出也可能是某种遗传体质既让人爱吸烟、又让人易患肺癌,1959 年结集为《吸烟:癌症之争》;那时他是英国烟草制造商常设委员会的顾问。「相关不等于因果」这句话本身不错,可此后的证据把他那一边的推测否掉了。

费希尔肖像
1953 年的照片,摄者不详 · 原件藏阿德莱德大学巴尔·史密斯图书馆珍本与特藏部 · Wikimedia Commons,公有领域。他晚年移居阿德莱德,遗稿、书信与照片后来都归了那里;本页引的论文,也都取自该馆扫描公开的《费希尔论文集》

生平

  1. 1890年2月17日
    生于伦敦

    父亲是一家拍卖行的合伙人。

  2. 1909
    进剑桥冈维尔与凯斯学院

    1912 年数学荣誉考试毕业,随后跟斯特拉顿读误差理论。

  3. 1912
    《拟合频数曲线的一个绝对判据》

    《数学信使》第 41 卷,六页。让观测出现的机会最大——他那时还叫它「最可能的」值。

  4. 1918
    《在孟德尔遗传假设下亲属之间的相关》

    《爱丁堡皇家学会汇刊》第 52 卷。「方差」一词出自这篇的第一段。

  5. 1919
    进罗瑟姆斯特德试验站

    同一年皮尔逊也请他去高尔顿实验室,他选了试验站。

  6. 1920
    平均偏差与均方差

    《皇家天文学会月报》第 80 卷。他后来说,这是第一次有人指出「充分」这种性质。

  7. 1921年11月17日
    宣读《理论统计的数学基础》

    次年印在《皇家学会哲学汇刊》A 辑第 222 卷,六十页。「似然」在开头的定义表里。

  8. 1925
    《研究工作者的统计方法》;《统计估计理论》

    前一本到他去世出了十三版;后一篇讲信息量与效率。

  9. 1929
    当选皇家学会会员
  10. 1930
    《自然选择的遗传理论》

    后几章讲人类的生育率与优生。

  11. 1933
    高尔顿优生学讲座教授

    接替退休的卡尔·皮尔逊;皮尔逊的讲席一拆为二,统计学系给了他的儿子伊贡·皮尔逊。

  12. 1935
    《实验设计》

    第二章:女士品茶。「零假设」这个名字出自这一章。

  13. 1943
    剑桥阿瑟·鲍尔弗遗传学讲座教授
  14. 1952
    封爵
  15. 1959
    《吸烟:癌症之争》;移居阿德莱德
  16. 1962年7月29日
    卒于阿德莱德

    七十二岁。

展品厅

绝大多数展品都可以亲手把玩——这是本馆的立馆之本;少数以叙述为主的,做成故事展签。

样本已经在手,哪一组参数最说得通

曲线的样子已知、参数未定:把每个观测点上的纵坐标取对数加起来,让它最大。1912 年他说这是「最可能的」值;十年后他改口,给它起了个新名字——似然,并说它不是概率。

1912 年,刚从剑桥数学荣誉考试毕业的费希尔在《数学信使》第 41 卷第 155–160 页登了一篇六页的短文,《拟合频数曲线的一个绝对判据》。他先说通行的两种办法都有任意之处:用最小二乘去拟合一条频数曲线,横轴换一种刻度,判据就跟着变;矩法让前几阶矩相等,也说不出为什么非选这几阶不可。他的办法是直接问:曲线的形式已知、参数待定,这一批观测出现的机会有多大——把每个观测点上曲线的纵坐标取对数相加,log P = S log f,让 P 最大。以误差的正态曲线 f = (h/√π)·exp(−h²(x − m)²) 为例,对 m、h 求导,得 m 就是平均数、2h² = n/Σv²,v 是各数离平均数的差。而当时通行的是 (n − 1)/Σv²。他指出埃及测量局贝内特 1907–08 年的讲义先把 P 对 m 积分、再对 h 求最大,得的正是 n − 1;可那样取的是一个截面面积最大,并不经过 P 真正的最高点。文末第 6 节说,P 只能逐点相比,不能乘上 dθ 在一块区域上积分、当成参数落在那里的概率:同一条曲线换一组参数来写,P 的值不变,区域上的概率却要多乘一个雅可比行列式。1912 年他还把这个最大值叫作「最可能的」;1922 年《理论统计的数学基础》开头的定义表里,他给 P 起了名字:似然——参数取某值的似然,正比于「若果真如此,得到这一批观测」的概率;1925 年那篇又写明似然「不是概率的同义词」。取最可能的值这个念头,丹尼尔·伯努利 1778 年、高斯 1809 年都用过;把它立成一个一般的方法、并与参数的概率分开的,是他。

峰顶在 m = 平均数 6.20、σ = √(Σv²/n) = 1.1811;通行的 √(Σv²/(n − 1)) = 1.2627 是先把 P 对 m 积分再求最大得来的,那一点的 log P 比峰顶低 0.0341。当前这一点的 P 是峰顶的 20.0%。

方差:两个原因各占几成

两个互不相干的原因各自造成标准差 σ₁、σ₂,合起来是 √(σ₁² + σ₂²)——所以该拿平方来记账。他 1918 年给这个平方起名「方差」,用它把孟德尔的一个个因子与身高的连续变异接上了。

1918 年,《爱丁堡皇家学会汇刊》第 52 卷登出费希尔的《在孟德尔遗传假设下亲属之间的相关》。第一段说:人的量度离开均值,大多服从正态律;两个互相独立的变异来源分别产生标准差 σ₁ 与 σ₂,合在一起的标准差是 √(σ₁² + σ₂²),所以分析变异的来源时,该拿标准差的平方当变异的度量——「我们把这个量称为方差」。统计学里的「方差」一般认为就出自这一句。它的好处是能相加,于是可以说某个原因占了总方差的百分之几。这篇要化解的是一场争论:生物统计学派量出身高这类性状在亲属之间连续地相关,孟德尔学派讲的却是一个个离散的因子。1903 年皮尔逊试过假设许多个同等重要的孟德尔因子相加,完全显性、随机婚配,算出父子相关 1/3、兄弟相关 5/12,都比实测的低。费希尔把每个因子的效应拆成可加的部分与显性偏差两块:父子之间只共有可加部分的一半,兄弟之间还要再加上显性偏差的四分之一。于是环境让两个相关按同一个比例变小,显性却让父子相关比兄弟相关降得多——两个相关一对比,显性与环境就分得开。他拿皮尔逊与李的身高数据(夫妻 .2804、父子 .5066、兄弟 .5433)算下来,结论是:照这个假设,非遗传的原因占到总方差的百分之五都不大可能。同一篇的目录里有一节叫「环境与显性比的数值;方差分析」——七年后那本书里的方差分析,名字在这里已经有了。

1 个因子、显性 d = 1.00、环境占 0%:父子相关 0.3333,兄弟相关 0.4167这正是皮尔逊 1903 年算出的 1/3 与 5/12——因子个数怎么变,两个数都不动。

同一批数,丢掉了几成信息

拿平均偏差估标准差,只用上了约 88% 的信息——八百个数只抵七百个。他由此定出「有效」与「充分」,又给一次观测含多少信息写下了式子:方差乘以 n,压不到 1/I 以下。

天文学家爱丁顿在《恒星运动》第 147 页说,估计正态分布的标准差,用平均偏差(各数离均值的绝对值取平均,乘上 √(π/2))比用均方差更好。费希尔 1920 年在《皇家天文学会月报》第 80 卷上算了两者:大样本里均方差那一个的方差是 σ²/(2n),平均偏差那一个是 σ²(π − 2)/(2n),大 π − 2 = 1.1416 倍;换成其他次方的偏差也一样,2 次方最好。他晚年在这篇的按语里说,这些结果前人早已得到,他与爱丁顿都不知道;而这篇真正要紧的一点是:知道了均方差,平均偏差的分布就与 σ 无关,再也给不出新的消息——他相信这是第一次有人注意到「充分」这种性质。1922 年那篇第 4 节把这件事写成三条判据:一致、有效、充分。1925 年的《统计估计理论》说得更直:平均偏差的效率将近 88%,八百个观测用它,只抵得上七百个用均方差;用中位数定正态分布的中心,效率是 2/π = 63.66%。同一篇第 5、6 节给出一般的形式。他的例子是柯西分布 1/(π(1 + (x − m)²)):n 个数的平均与一个数一样散,根本不收敛;似然方程在大样本里给出方差 2/n;中位数的方差是 π²/(4n),效率 8/π²,约 81%;从中位数出发照似然方程走一步,就得到一个有效的估计。大样本里有效估计的方差乘以 n 趋于一个定值 A,1/A 他称为这条误差曲线的内在精度,「也可以看成一次观测里含的信息量」,写成 ∫(1/y)(∂y/∂θ)² dx;独立观测的信息量相加。这条 1/(nI) 的界,在有限样本上的严格形式是拉奥 1945 年、克拉默 1946 年各自给出的,今称克拉默–拉奥下界。

n = 51平均偏差 σ₁的 n × 方差是 0.533,大样本理论 0.5708,下界 1/I = 0.5,效率 87.60%。

二十条什么也没施的地

二十条地同样对待,他拿二十张牌给它们贴上五种「肥料」再做方差分析:算出来的误差 124.1,真值 123.5。换成四个区组里各自抽签,误差降到 88.7,真值 92.0。

1925 年《研究工作者的统计方法》第 48 节讲田里的小区怎么排,用的是一份「匀地试验」的数:默瑟与霍尔在二十条并排的地上种饲用甜菜,一律同样对待,每条称一次根重。费希尔把二十张牌洗匀,给每条地贴上 A 到 E 五个字母之一、各四条,当它是五种肥料,再做方差分析。二十个数离总平均的平方和 289,766 拆成两份:「处理」58,725,4 个自由度;「试验误差」231,041,15 个自由度,由它估出单条地的标准差 124.1。这块地本来就没有处理,单条的真实标准差可以直接从二十个数算出来,是 123.5——「极为接近」,他说,这说明纯随机的排列保证算出来的试验误差是实际误差的无偏估计。第 45 例再加一条限制:把相邻的五条地编成一个区组,每个区组里五种各一,次序仍靠抽签(原文印作「分成 5 个区组」,按每组五条、表里区组 3 个自由度,应是四个)。平方和于是拆成三份:区组之间 154,483,处理 40,859,误差 94,424。区组间的差别极显著,误差的标准差降到 88.7,真值 92.0;剩下的方差差不多只有原来的 55%。他接着说:要是整整齐齐排成 ABCDE、EDCBA,这块地由一头到另一头的肥力梯度,恰好会让各处理之间的误差更小;可那时,由重复小区之间的差别估出来的误差不再代表处理之间的误差,显著性检验也就无从谈起。本件把那种整齐排法也算了一遍:处理之间实际的误差是 79.0,而估出来的是 95.9。这就是小区要靠抽签来排的理由。

他那一次:估出的误差 124.1,真值 123.5——「极为接近」。F 只有 0.95,五种「肥料」之间看不出差别,本来也没有。

镇馆之宝 · 亲手玩

八杯茶,七十种挑法

一位女士说她尝得出先倒的是奶还是茶。八杯,四杯对四杯,随机端上:一点分辨力都没有的人全挑对的机会是 1/70。先倒奶的四杯要是都加了糖,这个数就成了 35/70。

1935 年《实验设计》第二章第一句:「一位女士说,尝一口加了奶的茶,她分得出先倒进杯里的是奶还是茶。」费希尔拿它讲一个实验该怎样设计。八杯,四杯先倒奶、四杯先倒茶,按随机的次序端给她,事先告诉她是四对四,请她分成两组。从八杯里挑四杯,有 8×7×6×5 ÷ (4×3×2×1) = 70 种挑法,一点分辨力都没有的人全挑对的机会是 1/70。每一种都对三错一的挑法有 16 种,对二错二 36 种,对一错三 16 种,全错 1 种,合起来正好 70。所以三对一错不能算数:比它好或一样好的有 17 种,超过两成——他特意说明,算的时候要把更好的结果一起算进去。若每种只用三杯,全对的机会是 1/20,恰好落在「通常取的 5%」那条线上,这个实验就怎么也得不出显著的结论。第 8 节他给被检验的那个假设起了名字:零假设。「零假设从不被证明或确立,只可能在实验中被推翻。」第 9 节讲随机化为什么是这个检验的物理依据:要是先倒奶的那四杯恰好都加了糖,她只要按甜不甜分,全对的机会就不是 1/70,而是 35/70;而要求「每一杯在别的方面都一模一样」是做不到的,唯一的办法是让次序由真正的随机装置——牌、骰子或随机数表——来定。书里没有说这位女士是谁;据他女儿琼·费希尔·博克斯 1978 年写的传记,那是罗瑟姆斯特德的藻类学家穆丽尔·布里斯托尔。

拖「每种几杯」与「每种猜对几杯」,看这个结果有多稀罕;再按「先倒奶的都加了糖」

每种 4 杯、每种猜对 4 杯:一点分辨力都没有的人做到这样或更好,机会是 1/70 = 1.43%

两份聘书

1919 年,皮尔逊请他去伦敦的高尔顿实验室,哈彭登的一个农业试验站也请他去。他去了试验站;十四年后,他坐上了皮尔逊的讲席。

1919 年,二十九岁、还在中学教书的费希尔同时收到两份聘约。一份来自卡尔·皮尔逊,请他去伦敦大学学院的高尔顿实验室当首席统计员;另一份来自哈彭登的罗瑟姆斯特德试验站,站长 E. J. 拉塞尔请他去整理站里几十年攒下的田间记录。他选了试验站。在此之前两人已经结了怨:1917 年皮尔逊一方在《生物统计》上发文批评他 1915 年那篇相关系数分布的论文,事先没有告诉他;他 1918 年那篇讲孟德尔遗传与相关的长文先投给皇家学会,两位审稿人正是皮尔逊与庞尼特——庞尼特就是十年前请哈代出来解答遗传比例那个问题的人——两人都说有些部分自己无从判断,费希尔撤回稿子,改投爱丁堡。在罗瑟姆斯特德的十四年是他一生最多产的一段:1922 年那篇《理论统计的数学基础》署名处印着「罗瑟姆斯特德试验站首席统计员」,由拉塞尔提交皇家学会;1925 年那本书里的田间例子,多半就出自站里。1933 年皮尔逊退休,他的讲席一拆为二,统计学系给了皮尔逊的儿子伊贡·皮尔逊,高尔顿优生学讲席给了费希尔;此后两人在同一所学院里各管一摊,关系一直不好。1935 年《实验设计》的序言,落款是「高尔顿实验室,1935 年 7 月」——罗瑟姆斯特德的那一套办法,是在皮尔逊的旧讲席上写成书的。他自己在 1950 年重印 1922 年那篇时加了一段按语:「更年长、更审慎的作者,不会让论证被这样长的枝节打断……塞进太多东西,是年轻作者的通病。」

故事展签故事展签:两份聘书,一个试验站,一张讲席。

传承

他的工作没有留在十八世纪——每条链的终点,都是你今天正在使用的东西。

1912、1922:把参数调到让已有的数据最说得通,这个量叫似然最大似然成了估计参数的默认办法,逻辑回归、隐马尔可夫模型都照它拟合机器学习训练模型时压低的交叉熵,就是负的对数似然
1925:一次观测含多少信息,有效的估计量方差压不到 1/(nI) 以下1945、1946 年拉奥与克拉默把它写成有限样本上的下界雷达测距、定位与各种传感器能准到哪一步,统计推断里先算的就是这条界
1925:总平方和拆成处理、区组与误差;小区要靠抽签来排随机化与区组从田间试验搬进了医院,成了随机对照试验的规矩今天网站与应用上线新功能前做的 A/B 测试,用的是同一套道理
1935:八杯茶,零假设,全挑对的机会是 1/70显著性检验与 p 值进了每一门实验科学的论文今天每一份数据分析报告里「差别是否显著」那一行,都从这里来
1918:方差可以相加,身高的方差拆成可加、显性与环境几份数量遗传学与动植物育种据此估算遗传力,决定选哪一头种畜、哪一株种苗今天全基因组数据分析里「这个性状有几成可以由基因解释」,还是这样算
1920、1922:充分统计量——把一大堆数压成几个数,而一点不丢该有的信息统计学由此把「数据的约简」当成本分,抽样调查只报几个摘要数就够今天大数据的流式计算只存均值与平方和这类摘要,靠的就是这一条

他在哪几条专题里

专题是按技术组织的演进线,一条从概念提出拉到今天的器物。这里一个字都没手写, 全是 tracks.ts 推出来的。

语录

参数取某一个值的似然,正比于:假如果真如此,观测的全体恰好是现在这个样子的概率。

—— 《理论统计的数学基础》,《皇家学会哲学汇刊》A 辑第 222 卷(1922),第 310 页,定义表 · 中译

统计方法的目的,是数据的约简。

—— 同上,第 311 页 · 中译

零假设从不被证明或确立,只可能在实验的过程中被推翻。每一个实验,可以说都只是为了给事实一个推翻零假设的机会而存在。

—— 《实验设计》(1935)第二章第 8 节,第 19 页 · 中译

要断言一个自然现象可以由实验证明,我们需要的不是一次孤立的记录,而是一套可靠的做法。

—— 同上,第 7 节,第 16 页 · 中译